Zum Hauptinhalt springen Zur Suche springen Zur Hauptnavigation springen
Über uns · Forschung

Wissenschaftliche Studien aufbauen

Jeder Wissenszuwachs in der Tiergenetik beruht auf einer sorgfältigen Zusammenarbeit: zwischen Wissenschaftlern, Zuchtorganisationen und – vor allem – den einzelnen Züchtern.

Hier skizzieren wir, wie eine aussichtsreiche Studie aufgesetzt wird – beginnend mit der exakten Definition des Merkmals über die passende Organisation bis zur abschließenden Genotypisierung und Datenauswertung.

Exakte Phänotypen – Fälle und Kontrollen erkennen

Eine Assoziationsstudie vergleicht die DNA-Daten von Tieren, die ein spezifisches Merkmal zeigen, mit Tieren, die es sicher nicht aufweisen. Wie zuverlässig diese beiden Gruppen gebildet werden, entscheidet über alles, was die Statistik später leisten kann. Ein Tier in der falschen Gruppe erzeugt nicht einfach Rauschen – es verringert massiv die Aussicht auf Treffer und muss durch zuästzliche Probanden ausgeglichen werden. Der Genotyp ist immmer derselbe, der Phänotyp ist der Teil einer Studie, den Züchter und Zuchtorganisationen in der Hand haben und wo sich der Erfolg entscheidet.

Kriterium 1

Das Merkmal definieren

Der erste und grundlegende Schritt ist die Definition des Merkmals: Welcher exakte Befund weist ein Tier als betroffen aus? Mit welcher Methode wird der Befund erhoben, in welchem Alter, welche sonstigen Bedingungen/Einflussfaktoren sind bekannt/spielen eine Rolle?
Untauglich sind alle Diagnosen, die nicht schlüssig aufgebaut und nicht reproduzierbar sind.
Kriterium 2

Kontrollen organisieren

Kontrollen sind nicht einfache Tiere ohne Meldung, sondern müssen nach demselben Protokoll untersucht worden sein wie die Fälle. So müssen z.B. bei spät auftretenden Merkmalen die Kontrollen ein Alter erreicht haben, in dem das Merkmal sichtbar geworden wäre. Nicht klassifizierte Tiere, zu denen man Archivproben hat, sind keine Kontrollen – es sind Unbekannte.

Kriterium 3

Komplexität abbilden

Traditionell graduiert gemessene Merkmale sollten mit den Gradwerten in die Studie eingehen (HD, ED). In der Konzeption wären bekannte Subpopulationen bei den Fallzahlen zu berücksichtigen. Eine Zusammenfassung erhöht zwar die Anzahl der Probanden, würde aber bei der abschließenden Auswertung die Trennschärfe wieder stark reduzieren.

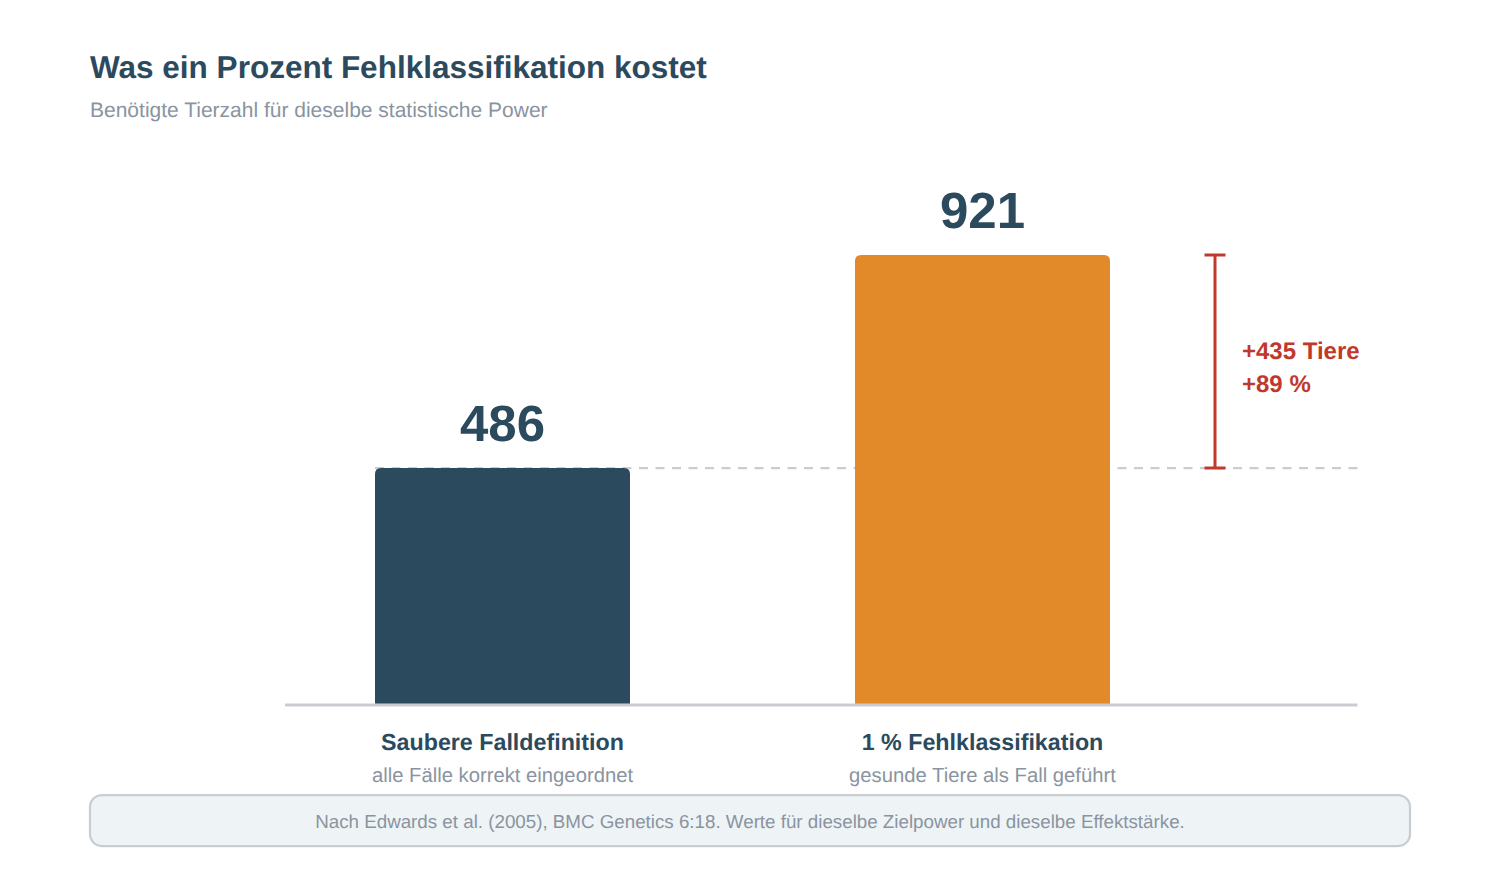
Balkendiagramm: Bei sauberer Falldefinition werden 486 Tiere benötigt, bei einem Prozent fälschlich als Fall eingeordneter gesunder Tiere 921 Tiere, ein Anstieg um 89 Prozent.
Benötigte Stichprobengröße für dieselbe statistische Power, nach Edwards et al. (2005).

Checkliste für einen brauchbaren Phänotyp

  • Eine schriftliche Definition des Merkmals, abgestimmt vor Beginn der Studie.
  • Eine standardisierte Untersuchung: wer untersucht, mit welcher Methode, ab welchem Mindestalter.
  • Für Fälle und Kontrollen dasselbe Protokoll.
  • Einheitliche, vollständige Dokumentation: Untersuchungsdatum, Tier-Identifikation, Alter, Untersucher, Befund(e), Proben-ID.
  • Benannte Ausschlusskriterien – zum Beispiel: überlagernder Befund, konkurrierende Diagnosen, unvollständige Untersuchung.

Quellen

  • Edwards BJ, Haynes C, Levenstien MA, Finch SJ, Gordon D (2005): Power and sample size calculations in the presence of phenotype errors for case/control genetic association studies. BMC Genetics 6:18. doi.org/10.1186/1471-2156-6-18

Die richtige Organisation – wie aus Beobachtungen Ergebnisse werden

Die erste Beobachtung des einzelnen Züchters ist immer der Anfang – er sieht was sonst vielleicht untergeht. Wesentlich ist die offene Kummunikation damit möglichst schnell klar wird, ob die Beobachtung ein Einzefall ist, oder auf ein erbliches Geschehen verweist. Dafür braucht es eine Stelle, die Befunde und Tiere über Jahre zusammenzuführtn, die Identität der Tiere sichert und regelt, wer was sehen darf. Genau dafür sind unsere DNA-Programme und das Animal Trust Center (ATC) konzipiert.

Rolle 1

Der einzelne Züchter

Er sieht, was sonst niemand sieht: den Welpen, der sich anders entwickelt, die Hündin, die zum zweiten Mal umrindert, das Fohlen mit dem auffälligen Gang. Entscheidend ist, auch die unauffälligen Tiere zu melden. Wer nur die Problemfälle weitergibt, liefert eine Studie ohne Kontrollen – und damit keine Studie.

Rolle 2

Die Zuchtorganisation

Der Verband ist die einzige Stelle, die einen Bestand vollständig überblickt: Zuchtbuch, Abstammungen, Wurfmeldungen und verbindliche Untersuchungen laufen dort zusammen. Er legt fest, welche Untersuchung für welches Tier verpflichtend ist – und schafft damit überhaupt erst einen einheitlichen Phänotyp.

Rolle 3

DNA-Programme

Eine Zuchtorganisation hinterlegt im ATC ihr eigenes DNA-Programm: welche Tests für welche Tiere gelten und welche Befunde innerhalb der Organisation geteilt werden. Aus vielen Einzelbestellungen wird so eine fortlaufende, einheitliche Datenerhebung.

Rolle 4

Animal Trust Center

Im ATC liegen Tiere und Befunde in einer digitalen Online-Tierakte, jeder Befund mit sicherer elektronischer Signatur. Der Halter entscheidet, was privat bleibt und was mit der Organisation geteilt wird – eine Studie entsteht damit nicht an den Züchtern vorbei, sondern mit ihrer ausdrücklichen Freigabe. Zu den Kontotypen

Probenmaterial – zwei Strategien

Ob eine Frage später beantwortet werden kann, entscheidet sich daran, ob das Material dafür vorhanden ist. Für die Probennahme gibt es zwei grundsätzlich verschiedene Wege. Beide sind legitim; sie unterscheiden sich nicht in der Qualität, sondern darin, wie viele Fragen sie offen halten.

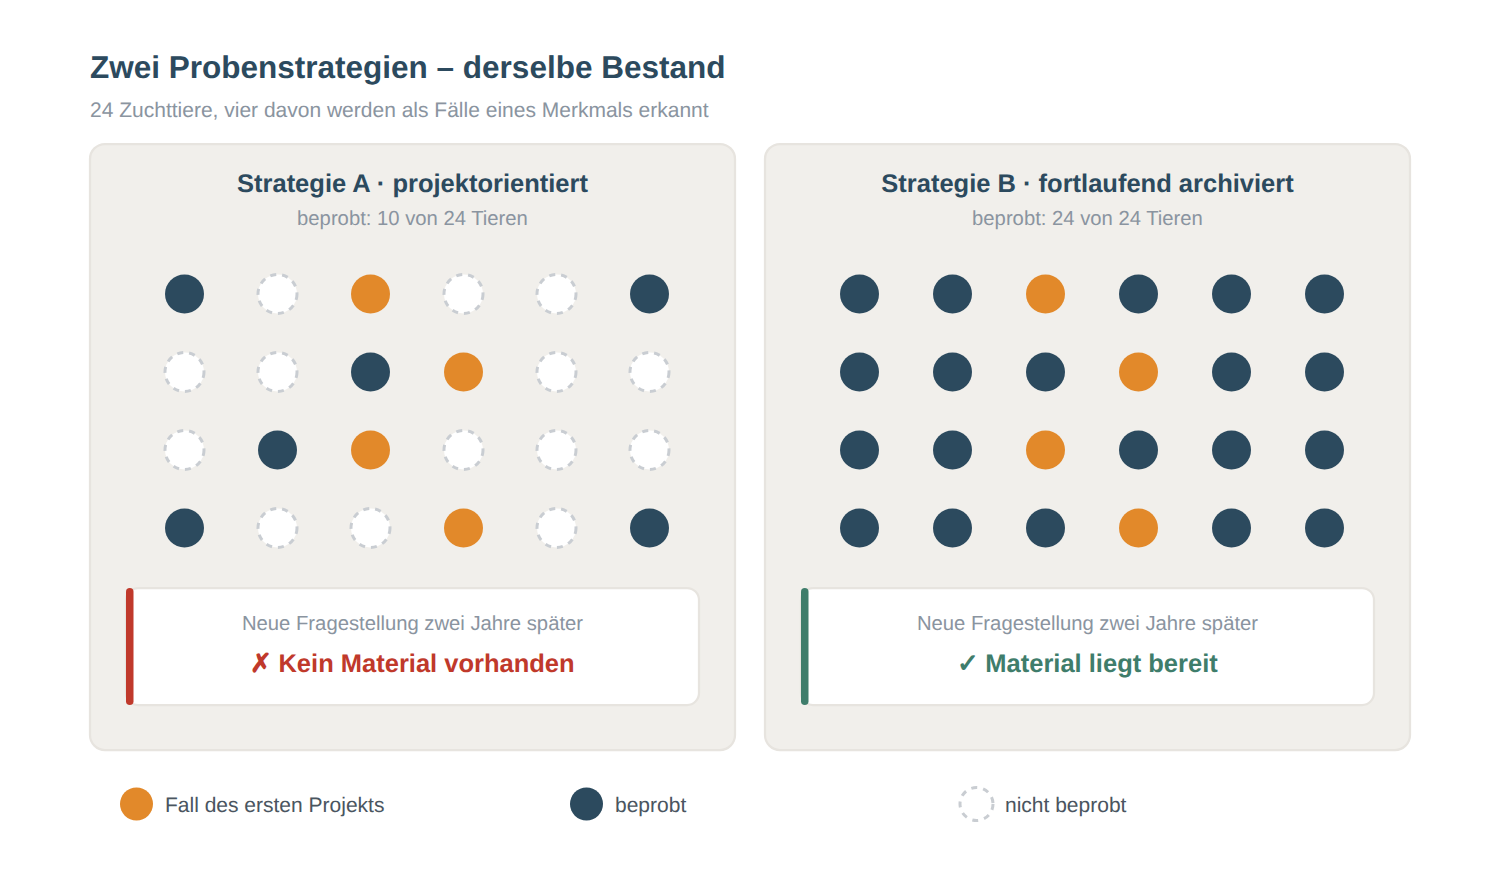
Zwei gegenübergestellte Bestände: bei der projektorientierten Beprobung sind nur die betroffenen Tiere und die Kontrollen beprobt, bei der fortlaufenden Archivierung alle Zuchttiere; für eine neue Fragestellung steht im ersten Fall kein Material bereit, im zweiten Fall sofort.
Derselbe Bestand, zwei Probenstrategien – und was passiert, wenn zwei Jahre später eine neue Frage auftaucht.
Strategie A

Projektorientiert beproben

Beprobt werden ausschließlich die Tiere, die als betroffen von einem bestimmten Merkmal identifiziert wurden, sowie die dazu passenden Kontrollen. Die Sammlung beginnt mit der Fragestellung und endet mit ihr.

Vorteil

  • Die Kosten bleiben auf wenige Tiere begrenzt und sind vorab kalkulierbar.
  • Der organisatorische Aufwand ist überschaubar und zeitlich befristet.
  • Für eine klar umrissene, bereits formulierte Frage der schnellste Weg.

Nachteil

  • Keine weitere Verwendung: Für jede neue Frage muss neu gesammelt werden.
  • Rückblickend lässt sich nichts nachholen – Tiere sind verkauft, verstorben oder nicht mehr beprobbar.
  • Die Kontrollgruppe ist auf die ursprüngliche Fragestellung zugeschnitten und selten wiederverwendbar.
Strategie B

Fortlaufend archivieren

Von allen Zuchttieren wird eine Probe genommen und eingelagert – unabhängig davon, ob gerade ein Projekt läuft. Das Archiv wächst mit dem Bestand und ist nicht auf ein Merkmal festgelegt.

Vorteil

  • Wonach gesucht wird, ist nicht vorab festgelegt: Jede spätere Frage findet Material vor.
  • Auch retrospektive Auswertungen sind möglich, weil frühere Jahrgänge enthalten sind.
  • Fälle und Kontrollen lassen sich nachträglich passend auswählen, statt sie vorab festzulegen.
  • Der Bestand ist vollständig abgebildet – auch die unauffälligen Tiere.

Nachteil

  • Höhere Kosten, weil jedes Zuchttier beprobt wird und nicht nur die benötigten.
  • Laufender organisatorischer Aufwand und dauerhafte Lagerung.
  • Ein Teil des Materials wird nie gebraucht – welcher Teil, weiß man vorher nicht.

Quelle

  • Groeneveld LF, Gregusson S, Guldbrandtsen B, Hiemstra SJ, Hveem K, Kantanen J, Lohi H, Stroemstedt L, Berg P (2016): Domesticated Animal Biobanking: Land of Opportunity. PLOS Biology 14(7):e1002523. doi.org/10.1371/journal.pbio.1002523

Assoziationsstudien – wenn genügend informative Proben vorliegen

Eine Assoziationsstudie vergleicht die Markergenotypen von Fällen und Kontrollen über das gesamte Genom und fragt, wo sich beide Gruppen systematisch unterscheiden. Möglich wird sie in dem Moment, in dem genügend informative Proben zusammengekommen sind. Wie viele das sind, bestimmt das Merkmal und nicht das Budget – und der Unterschied zwischen einem monogenen und einem komplexen Merkmal ist keine Frage des Grades, sondern der Größenordnung.

~20

Tiere für ein monogenes Merkmal

Karlsson et al. (2007) haben mendelnde Merkmale innerhalb einer Rasse mit einem Array von rund 27.000 SNPs und etwa 20 Hunden auf Regionen unter 1 Mb kartiert. Die anschließende Feinkartierung (fine mapping) über zwei Rassen grenzte den S-Lokus auf etwa 100 kb innerhalb von MITF ein. Daraus folgt die Strategie: innerhalb der Rasse kartieren, über Rassen hinweg feinkartieren.

4.200+

Tiere für komplexe Merkmale

Hayward et al. (2016) haben über 4.200 Hunde an 180.000 Markern genotypisiert und dabei signifikante Loci für Hüftgelenkdysplasie, Ellbogendysplasie, idiopathische Epilepsie, Lymphom, Mastzelltumor und granulomatöse Kolitis gefunden. Wer von 30 Proben eine Antwort zur HD erwartet, arbeitet drei Größenordnungen unterhalb dessen, was das Merkmal verlangt.

100×

Warum Hunde weniger Tiere brauchen

Sutter et al. (2004) haben das Kopplungsungleichgewicht (linkage disequilibrium, LD) innerhalb von Rassen gemessen: von 400–700 kb bei Golden und Labrador Retriever bis 3–3,2 Mb bei Berner Sennenhund und Pekingese – bis zu hundertmal weiter als beim Menschen, entsprechend weniger Marker sind nötig. Die Reichweite ist allerdings rassespezifisch: Zwischen diesen Rassen unterscheidet sie sich um etwa das Fünffache.

Vom Array zur Sequenz

SNP-Arrays reichen aus, um Assoziationen innerhalb einer Rasse zu finden. Über mehrere Rassen hinweg und bei Mischlingen zerfällt das Kopplungsungleichgewicht zwischen den Markern, und dem Array geht die Power aus. Zwei Entwicklungen haben das verändert.

Imputation gegen ein Sequenzpanel

Hayward et al. (2019) haben Array-Genotypen gegen 365 vollständig sequenzierte Hunde und Wölfe imputiert und die Zahl der auswertbaren Marker von 173.000 auf 24,0 Millionen erhöht, bei einer Gesamtgenauigkeit von 88,4 Prozent (Rassehunde 89,7 Prozent, Dorfhunde 84,2 Prozent). Der Gewinn blieb nicht theoretisch: Auf CFA20 zeigte sich ein neuer signifikanter Lokus für den Kreuzbandriss.

Referenzpanels einer anderen Größenordnung

Das Dog10K-Konsortium hat 1.987 Caniden bei zwanzigfacher Abdeckung sequenziert und über 48 Millionen Varianten beschrieben (Meadows et al. 2023). Beim Pferd sind die Ressourcen deutlich schwächer: Reich et al. (2022) erreichten gegen 317 Pferdegenome ab einem 60K-Array nur eine Imputationsgenauigkeit von 0,66, ab einem 670K-Array dagegen rund 0,90. Beim Pferd trägt die Abkürzung über ein dünnes Array also nicht.

Quellen

  • Sutter NB, Eberle MA, Parker HG, Pullar BJ, Kirkness EF, Kruglyak L, Ostrander EA (2004): Extensive and breed-specific linkage disequilibrium in Canis familiaris. Genome Research 14(12):2388–2396. doi.org/10.1101/gr.3147604
  • Karlsson EK, Baranowska I, Wade CM, Salmon Hillbertz NHC, Zody MC, Anderson N, Biagi TM, Patterson N, Rosengren Pielberg G, Kulbokas EJ, Comstock KE, Keller ET, Mesirov JP, von Euler H, Kämpe O, Hedhammar Å, Lander ES, Andersson G, Andersson L, Lindblad-Toh K (2007): Efficient mapping of mendelian traits in dogs through genome-wide association. Nature Genetics 39(11):1321–1328. doi.org/10.1038/ng.2007.10
  • Hayward JJ, Castelhano MG, Oliveira KC, Corey E, Balkman C, Baxter TL, Casal ML, Center SA, Fang M, Garrison SJ, Kalla SE, Korniliev P, Kotlikoff MI, Moise NS, Shannon LM, Simpson KW, Sutter NB, Todhunter RJ, Boyko AR (2016): Complex disease and phenotype mapping in the domestic dog. Nature Communications 7:10460. doi.org/10.1038/ncomms10460
  • Hayward JJ, White ME, Boyle M, Shannon LM, Casal ML, Castelhano MG, Center SA, Meyers-Wallen VN, Simpson KW, Sutter NB, Todhunter RJ, Boyko AR (2019): Imputation of canine genotype array data using 365 whole-genome sequences improves power of genome-wide association studies. PLOS Genetics 15(9):e1008003. doi.org/10.1371/journal.pgen.1008003
  • Meadows JRS, Kidd JM, Wang G-D, Parker HG, Schall PZ, Bianchi M, Christmas MJ, Bougiouri K, Buckley RM, Hitte C et al. (2023): Genome sequencing of 2000 canids by the Dog10K consortium advances the understanding of demography, genome function and architecture. Genome Biology 24:187. doi.org/10.1186/s13059-023-03023-7
  • Reich P, Falker-Gieske C, Pook T, Tetens J (2022): Development and validation of a horse reference panel for genotype imputation. Genetics Selection Evolution 54:49. doi.org/10.1186/s12711-022-00740-8

Publikationen

Assoziationsstudien entstehen in Zusammenarbeit mit universitären Arbeitsgruppen, und das Ergebnis gehört in die Fachliteratur. Die folgende Auswahl zeigt Arbeiten, an denen Wissenschaftler von Generatio als Autoren oder Ko-Autoren beteiligt sind – ausgewählt nach ihrem Bezug zu den auf dieser Seite beschriebenen Methoden.

Eberhard Manz

Gründer und Geschäftsführer, Generatio GmbH – Center for Animal Genetics

  • Tan K, Adeniyi OO, Letko A, Manz E, Wagner HW, Zanolari P, More M, Gutierrez-Reynoso GA, Drögemüller C, Lühken G (2026): Genome-wide SNP-based genomic diversity and population structure analysis in alpaca populations from Europe and Peru. G3 (Bethesda) 16(9):jkag157. doi.org/10.1093/g3journal/jkag157
  • Rietmann SJ, Lange A, Soto S, Thom N, Manz E, Jagannathan V, Mayer U, Leeb T (2024): KRT5 in-frame deletion in a family of German Shepherd dogs with split paw pad disease resembling localized epidermolysis bullosa simplex in human patients. Animal Genetics 55(4):692–696. doi.org/10.1111/age.13444
  • Tan K, Adeniyi OO, Letko A, Rudd Garces G, Manz E, Wagner H, Zanolari P, Drögemüller C, Lühken G (2024): Identification of genomic regions associated with differences in fleece type in Huacaya and Suri alpacas (Vicugna pacos). Animal Genetics 55(1):163–167. doi.org/10.1111/age.13377
  • Tan K, Roy M, Manz E, Wagner H, Zanolari P, Drögemüller C, Lühken G (2022): The KIT:c.376G>A variant in German and Swiss alpacas (Vicugna pacos) with different coat colors. Animal Genetics 53(5):718–720. doi.org/10.1111/age.13231
  • Manz E, Tellhelm B, Krawczak M (2017): Prospective evaluation of a patented DNA test for canine hip dysplasia (CHD). PLOS ONE 12(8):e0182093. doi.org/10.1371/journal.pone.0182093
  • Gerber M, Fischer A, Jagannathan V, Drögemüller M, Drögemüller C, Schmidt MJ, Bernardino F, Manz E, Matiasek K, Rentmeister K, Leeb T (2015): A deletion in the VLDLR gene in Eurasier dogs with cerebellar hypoplasia resembling a Dandy-Walker-like malformation (DWLM). PLOS ONE 10(2):e0108917. doi.org/10.1371/journal.pone.0108917

Frühere Arbeiten an der Medizinischen Hochschule Hannover befassten sich mit Y-chromosomalen Genfamilien bei Mensch und Rind sowie mit DNA-Fingerprinting zum Abstammungsnachweis – unter anderem Nürnberg P et al. (1998), Paternity assessment in rhesus macaques (Macaca mulatta): multilocus DNA fingerprinting. American Journal of Primatology 44(1):1–18.

Arnav Mehrotra

Bioinformatik und quantitative Genetik, Generatio GmbH – Center for Animal Genetics

  • Gorssen W, Kadri NK, Khayatzadeh N, Leonard AS, He Q, Mehrotra A, Neuenschwander S, Pausch H (2026): Genetic analysis of iris pigmentation in Swiss pig breeds identifies a missense KITLG variant as a potential causal factor for pale and heterochromatic irises. Genetics Selection Evolution 58(1):22. doi.org/10.1186/s12711-026-01040-1
  • Nosková A, Mehrotra A, Kadri NK, Lloret-Villas A, Neuenschwander S, Hofer A, Pausch H (2023): Comparison of two multi-trait association testing methods and sequence-based fine mapping of six additive QTL in Swiss Large White pigs. BMC Genomics 24:192. doi.org/10.1186/s12864-023-09295-4
  • Mehrotra A, Bhushan B, Kumar A, Panigrahi M et al. (2022): A 1.6 Mb region on SSC2 is associated with antibody response to classical swine fever vaccination in a mixed pig population. Animal Biotechnology 33(6):1128–1133. doi.org/10.1080/10495398.2021.1873145
  • Mehrotra A, Bhushan B, Karthikeyan A, Singh A, Panda S, Bhati M, Panigrahi M, Dutt T, Mishra BP, Pausch H, Kumar A (2021): Genome-wide SNP data unravel the ancestry and signatures of divergent selection in Ghurrah pigs of India. Livestock Science 250:104587. doi.org/10.1016/j.livsci.2021.104587
  • Singh A, Kumar A, Mehrotra A et al. (2021): Estimation of linkage disequilibrium levels and allele frequency distribution in crossbred Vrindavani cattle using 50K SNP data. PLOS ONE 16(11):e0259572. doi.org/10.1371/journal.pone.0259572

Vor dem Wechsel zu Generatio arbeitete Arnav Mehrotra in der Arbeitsgruppe für Tiergenomik an der ETH Zürich und am Indian Veterinary Research Institute. Der Arbeitsschwerpunkt – Assoziationsstudien, Selektionssignaturen, sequenzbasierte Feinkartierung – entspricht genau den Verfahren, die auf dieser Seite beschrieben sind.

Auswahl, kein vollständiges Schriftenverzeichnis. Recherchestand: Europe PMC und Crossref, September 2026. Über die angegebenen DOI ist jede Arbeit dauerhaft auffindbar.